Des agents IA qui répondaient en 107 s : le goulot n’était pas l’IA
Sous la charge de cent comptes simulés, la plateforme ne livrait que 81 réponses sur 199, en 107 s en médiane. Trois files séparées, des workers réservés à la discussion et des verrous corrigés ont ramené ce temps à 6 s.
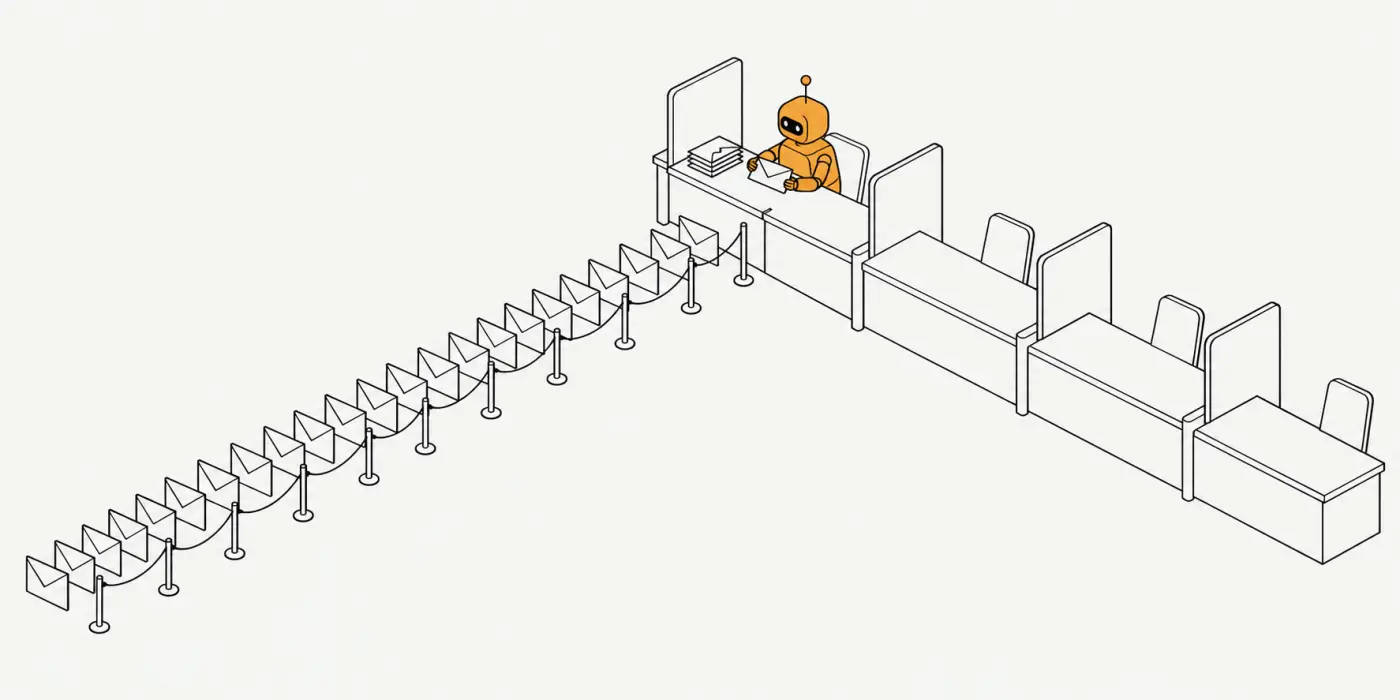
Quand on construit des agents IA, on finit toujours par regarder le modèle quand quelque chose est lent. Le fournisseur est chargé, le prompt est trop long, il faudrait un modèle plus rapide. Sur le projet étudié ici, une plateforme d’employés IA, la démarche a été inverse : vérifier avant d’accuser qui que ce soit. La question de départ était simple : que se passe-t‑il si cent entreprises utilisent la plateforme en même temps ?
1. Le symptôme : des messages restés sans réponse
Le principe de la plateforme : chaque entreprise recrute des employés IA (une assistante, un commercial…), leur branche ses outils (Gmail, Agenda), et leur parle comme à un collègue. Un employé répond aux messages, mais il a aussi des missions planifiées (le tri des mails du matin, un récapitulatif) et des surveillances (un nouveau mail arrive, il lance une mission).
Techniquement, c’est une application Symfony servie par FrankenPHP, une base PostgreSQL, et Symfony Messenger pour tout ce qui tourne en arrière-plan. Quand un manager envoie un message, la requête HTTP crée un travail, le pose dans une file, et l’interface relit la discussion jusqu’à ce que la réponse apparaisse. C’est un worker qui fait le vrai travail : appeler le modèle, exécuter les outils, rappeler le modèle, et ainsi de suite jusqu’à la réponse.
En production, il y avait un seul worker, qui consommait aussi le planificateur :
command: ["php", "bin/console", "messenger:consume", "async", "scheduler_default",
          "--time-limit=3600", "--memory-limit=256M"]
Avec quelques comptes, aucun problème. La simulation de cent comptes a donné ceci : sur 199 messages envoyés, 81 réponses reçues. Les 118 autres n’avaient toujours pas de réponse au bout de 4 minutes, le délai au-delà duquel le script de charge abandonne. Et les messages qui obtenaient une réponse l’obtenaient en 107 secondes en médiane, 229 secondes au 95e centile.
Deux minutes pour répondre « Qu’est-ce que j’ai comme rendez-vous aujourd’hui ? ». Un utilisateur aurait conclu que l’IA était lente. Elle ne l’était pas.
2. Simuler cent comptes, sans payer cent comptes
Pour savoir où ça coince, il fallait reproduire la charge sur la vraie pile : PostgreSQL 17, FrankenPHP, les workers Messenger et le planificateur, en Docker, en HTTP. Pas un benchmark de route isolée, mais des managers simulés qui utilisent l’application comme l’interface le fait.
Le script de charge (en Node) fait, pour chaque manager : connexion, liste des employés et des canaux toutes les 10 secondes, un message de temps en temps à un employé, puis la discussion relue toutes les 2 secondes jusqu’à la réponse. Il mesure deux temps, du clic à l’écran : le premier signe de vie (« Je regarde ça tout de suite. ») et la réponse finale.
Le scénario de pointe :
- 100 comptes, chacun avec une assistante et un commercial, Gmail et Agenda branchés ;
- tous les managers connectés pendant 10 minutes, un message toutes les 3 minutes en moyenne chacun ;
- la rafale du matin : toutes les missions planifiées de tous les comptes partent à la même minute ;
- les boîtes mail reçoivent un mail toutes les 10 minutes, ce qui déclenche les surveillances, qui lancent des missions.
Restait le coût. Cent comptes qui sollicitent un vrai modèle pendant des dizaines d’essais, ça finit par se payer, et surtout ça mesure le fournisseur autant que l’application. Les deux dépendances externes ont donc été simulées. Les services branchés (passés par Composio) répondent en 0,2 à 0,8 seconde par appel. Et l’IA est remplacée par un décorateur qui ne coûte rien, mais qui prend le temps que prendrait DeepSeek, mesuré en direct : 0,45 seconde avant le premier mot, 115 jetons par seconde, et une réponse sur vingt trois fois plus lente.
private function wait(int $inputTokens, int $outputTokens): void
{
    $seconds = 0.45 + $inputTokens / 20000 + $outputTokens / 115;
    $seconds *= 0.8 + random_int(0, 70) / 100;
    // une réponse sur vingt est bien plus lente (fournisseur chargé)
    if (0 === random_int(0, 19)) {
        $seconds *= 3;
    }
    // …
    usleep((int) ($seconds * 1_000_000));
}
L’IA simulée ne se contente pas d’attendre. Elle travaille comme un employé : une discussion appelle de zéro à deux outils de lecture avant de répondre, une mission deux à quatre avant son compte rendu. Et ce sont de vrais outils de sa liste, que le worker exécute réellement contre les services simulés. Le worker fait donc exactement le même chemin qu’en production, seul le temps de réflexion du modèle est imité. Le tout s’active par variable d’environnement (SIMULATED_LLM=1, SIMULATED_SERVICES=1), jamais en production.
3. Le constat : FrankenPHP tient, le worker unique sature
Premier réflexe en voyant 107 secondes : le serveur HTTP est à genoux. Les mesures disent l’inverse. Pendant la simulation « avant », le script a fait 30 679 requêtes HTTP, zéro erreur, entre 20 et 70 ms. FrankenPHP n’était pas le goulot.
Le goulot, c’était le worker unique. Un employé qui travaille occupe un worker tout le temps de son travail : les appels au modèle, les appels aux outils, les allers-retours. Une réponse, c’est 5 à 15 secondes. Une mission, 10 à 30. Avec un seul processus, tout passe à la queue leu leu : les discussions, les missions de la rafale, les surveillances.
Pour le prouver, l’équipe a ajouté deux colonnes aux travaux : startedAt, le moment où un worker prend le travail pour la première fois, et activeAt, sa dernière activité. L’attente en file, c’est startedAt - createdAt. Une commande (app:charge:rapport) la calcule par file. Le verdict : une discussion attendait 301 secondes en médiane dans la file avant qu’un worker la prenne, 403 au 95e centile.
Le reste du tableau était pire. Les missions de la rafale du matin : 0 sur 200 faites en 13 minutes, jamais prises. Et 1 200 surveillances en retard dans la file, parce que le passage de chaque minute renvoyait une surveillance qui n’avait pas encore été regardée, et qu’elles s’empilaient en doublons.
Ce dernier point a une cause précise. Le planificateur tournait dans le même worker, et chaque passage de minute interrogeait lui-même les services pour chaque surveillance. Plus il y avait de comptes, plus le passage était long, et plus il retardait tout le reste.
Le modèle mettait quelques secondes à répondre. Le message, lui, attendait cinq minutes qu’on veuille bien le donner au modèle.
4. Trois files, et des workers réservés à la discussion
Ajouter des workers était nécessaire, mais pas suffisant. Avec huit workers et une seule file, la rafale du matin (200 à 300 missions d’un coup) les aurait tous occupés, et un manager qui écrit à 9 h 01 aurait attendu derrière toutes les missions. Il fallait distinguer les travaux selon une question simple : quelqu’un attend‑il la réponse ?
D’où trois files dans messenger.yaml, toutes dans la même table PostgreSQL, séparées par leur nom :
interactive:
    dsn: '%env(MESSENGER_TRANSPORT_DSN)%'
    options:
        queue_name: interactive
watches:
    dsn: '%env(MESSENGER_TRANSPORT_DSN)%'
    options:
        queue_name: watches
background:
    dsn: '%env(MESSENGER_TRANSPORT_DSN)%'
    options:
queue_name: background- interactive : la discussion, les canaux, Telegram, le bouton « Lancer maintenant », la reprise après un accord. Quelqu’un est devant son écran.
- watches : regarder les surveillances. Court, envoyé par le passage de chaque minute.
- background : les missions à heure fixe ou déclenchées, les relais entre collègues.
La file n’est pas choisie par le type de message, mais au moment de l’envoi, d’après le travail lui-même. Une mission lancée à la main par une personne passe dans la file interactive ; la même mission planifiée part dans le fond :
public static function laneOf(string $kind, bool $manual): string
{
    $waited = \in_array($kind, [Task::CHAT, Task::CHANNEL], true)
        || (Task::MISSION === $kind && $manual);

    return $waited ? self::INTERACTIVE : self::BACKGROUND;
}

private function queue(Task $task): void
{
    $this->bus->dispatch(new RunTask($task->id()),
        [new TransportNamesStamp([self::lane($task)])]);
}
Ensuite, trois sortes de processus dans compose.yaml. Les workers généraux consomment toutes les files, dans l’ordre de priorité : Messenger ne prend un message dans une file que si celles d’avant sont vides. Des workers réservés ne consomment que la discussion, et relèvent la file deux fois par seconde au lieu d’une. Et le planificateur a désormais son propre processus :
worker:
  deploy:
    replicas: ${WORKERS:-8}
  command: ["php", "bin/console", "messenger:consume",
            "interactive", "watches", "background", "async", …]

worker-chat:
  deploy:
    replicas: ${WORKERS_CHAT:-4}
  command: ["php", "bin/console", "messenger:consume",
            "interactive", "--sleep=0.5", …]

scheduler:
  command: ["php", "bin/console", "messenger:consume", "scheduler_default", …]
Les workers réservés sont la vraie garantie. La priorité seule ne suffit pas : un worker général qui a commencé une mission de 30 secondes ne l’interrompt pas parce qu’un message arrive. Pendant la rafale, les huit workers généraux peuvent être tous occupés par des missions ; les quatre de la discussion, eux, restent libres pour les gens qui attendent.
Dernier morceau : les surveillances. Le passage de chaque minute n’interroge plus les services ; il envoie un message CheckWatch dans la file des surveillances, et ce sont les workers qui interrogent Gmail ou l’Agenda, en parallèle. Le passage reste court quel que soit le nombre de comptes. Et pour en finir avec les doublons, une surveillance n’a jamais qu’un message en file : elle est marquée « réclamée » à l’envoi, et le passage suivant ne la renvoie pas tant qu’elle n’a pas été regardée (au-delà de 15 minutes, son message est tenu pour perdu et elle repart).
// file chargée : la précédente attend encore son tour, une seule par surveillance
if ($state->claimed($now, self::WATCH_LOST)) {
    return 0;
}
$state->claim($now);
5. Le piège des verrous qui expiraient à 10 minutes
En passant d’un worker à douze, un problème jusque-là invisible est devenu réel : deux processus peuvent maintenant essayer de faire le même travail. Le code avait prévu le cas, avec un verrou par travail :
$lock = $this->locks->createLock('team-task-'.$taskId, 600);Le verrou passait par Symfony Lock, configuré par une variable LOCK_DSN. Le commentaire du compose.yaml disait « verrous consultatifs PostgreSQL ». La valeur disait autre chose :
LOCK_DSN: postgresql://…@db:5432/…Avec un DSN postgresql:// seul, Symfony ne choisit pas les verrous consultatifs, mais un stockage dans une table de verrous, avec une durée de vie. Ici 600 secondes : au bout de 10 minutes, le verrou expire, même si le worker travaille encore. Un long travail pouvait donc être repris en double. Et la table elle-même posait un second problème : sa création ratait quand plusieurs connexions arrivaient en même temps, ce qui se traduisait par une erreur 500 à la connexion.
La correction tient en un mot dans l’adresse :
LOCK_DSN: postgresql+advisory://…@db:5432/…Avec +advisory, ce sont de vrais verrous consultatifs PostgreSQL : pas de table, pas d’expiration, et ils sont libérés automatiquement si le processus qui les tient s’arrête. C’est exactement la sémantique qu’il faut pour « un worker tient ce travail » : le verrou dure tant que le worker est vivant, ni plus, ni moins.
Ce qui me frappe dans ce cas, c’est que la configuration avait l’air juste. Le commentaire décrivait l’intention, la valeur en faisait une autre, et avec un seul worker la différence ne pouvait jamais se voir.
6. Les travaux « bloqués » qui ne l’étaient pas
Le passage de chaque minute contenait un garde-fou : un travail resté « en cours » trop longtemps, parce qu’un processus s’est arrêté au milieu, est clos, et le manager est prévenu. La requête qui les cherchait :
->where('t.status IN (:s)')->andWhere('t.createdAt < :b')
->setParameter('s', [TaskStatus::Queued->value, TaskStatus::Running->value])
Autrement dit : tout travail créé depuis plus de 20 minutes et pas terminé, qu’il soit en cours ou encore en file, était abandonné avec le message « le travail est resté bloqué, il faudra me le redemander ». Avec un worker et peu de comptes, un travail en file depuis 20 minutes était effectivement anormal. Sous charge, c’était le fonctionnement normal d’une file pleine. Les missions de la rafale du matin auraient disparu sans avoir jamais tourné, remplacées par un message d’excuse.
La nouvelle règle distingue les deux cas :
->where('(t.status = :running AND COALESCE(t.activeAt, t.createdAt) < :idle)
OR (t.status = :queued AND t.createdAt < :queuedBefore)')- un travail commencé est suspect s’il n’a eu aucune activité depuis 20 minutes (le worker met à jour
activeAtà chaque étape) ; - un travail en file attend son tour, jusqu’à 6 heures, au-delà desquelles son message a dû se perdre.
Et même suspect, il n’est clos que si aucun worker ne le tient :
public function abandonIfIdle(Task $task, string $reason): bool
{
    $lock = $this->locks->createLock('team-task-'.$task->id(), 600);
    if (!$lock->acquire()) {
        return false;  // un worker l'a encore en main
    }
    // …
}
C’est là que les deux corrections se rejoignent. Ce test ne vaut que si le verrou dit la vérité. Avec l’ancienne table de verrous expirant à 10 minutes, un travail long aurait eu un verrou « libre » alors que son worker tournait encore. Avec les verrous consultatifs, un verrou libre veut vraiment dire qu’aucun processus vivant ne s’en occupe.
7. Le résultat, puis le test avec le vrai modèle
Même simulation, même IA simulée, avec 8 workers généraux et 4 de discussion :
| Mesure | Avant (1 worker) | Après (8 + 4) |
|---|---|---|
| Réponses reçues | 81 sur 199 | 366 sur 366 |
| Premier signe de vie (p50) | 103 s | 2,1 s |
| Réponse p50 / p95 | 107 s / 229 s | 6,1 s / 12,2 s |
| Attente en file de la discussion | 301 s / 403 s | 0 s / 1 s |
| Missions de la rafale | 0 sur 200 | 300 sur 300 |
| Surveillances en retard | 1 200 | 0 |
| Requêtes HTTP | 0 erreur, 20 à 70 ms | 0 erreur, 16 à 77 ms |
Le nombre de messages diffère pour une raison simple : dans le script, un manager n’écrit le suivant qu’après avoir reçu la réponse au précédent. Avant, ils attendaient. Pour la même raison, il y avait plus de requêtes HTTP avant (30 679 contre 13 728) : des managers qui relisent la discussion toutes les 2 secondes pendant des minutes.
L’attente en file de la discussion reste à 0 seconde en médiane, rafale comprise. Les missions, elles, attendent : 240 secondes en médiane, 412 au 95e centile. C’est voulu. Personne n’est devant l’écran pour le tri du matin, il peut prendre quelques minutes ; une réponse à un message, non. Chaque worker, enfin, coûte 34 Mo de mémoire.
Une simulation reste une simulation. L’essai a donc été refait avec DeepSeek pour de vrai, à plus petite échelle : 20 comptes, 8 minutes, un message toutes les 2 minutes par manager, rafale du matin comprise, mêmes workers.
- 192 travaux (86 discussions, 106 missions) : 192 faits, 0 échec, 0 problème noté ;
- réponse p50 / p95 / max : 10,1 s / 18,2 s / 24 s, premier signe de vie à 2,1 s ;
- attente en file : 0 seconde pour la discussion, 26 secondes pour les missions (médianes) ;
- 5,7 étapes par travail en moyenne, 11,7 millions de jetons lus, 0,22 million écrits ;
- coût réel : 0,86 $, soit 0,45 centime par travail.
Avec le vrai modèle, une réponse prend environ 10 secondes au lieu de 6 : c’est le temps du modèle, pas celui de l’attente. Les réponses ont aussi été relues : elles citent les vrais mails des boîtes simulées, disent ce qu’elles ne trouvent pas, et ne montrent aucun détail technique.
8. Dimensionner sans deviner
Ce que j’en retiens d’abord, c’est la règle qui sort de tout ça. Un employé qui travaille occupe un worker le temps de son travail. Le nombre de workers se calcule donc comme un guichet : combien de demandes arrivent, combien de temps chacune occupe un guichet.
Pour la discussion :
WORKERS_CHAT ≥ messages par minute à la pointe × durée d'une réponse ÷ 60 (+ marge)Avec DeepSeek, une réponse dure environ 10 secondes. Cent comptes très actifs, c’est 35 messages par minute : 35 × 10 ÷ 60 ≈ 6. D’où 4 à 6 workers réservés à la discussion.
Pour les missions, la question n’est pas la même : personne n’attend, on veut juste que la rafale du matin soit finie en quelques minutes. Le nombre de workers généraux se déduit du nombre de missions, de leur durée et du délai qu’on se donne pour les finir. Pour 300 missions en 10 minutes avec DeepSeek, on arrive à 8 environ, plus si la rafale doit être plus courte.
Et la limite pratique : un worker, c’est 34 Mo et une connexion PostgreSQL. Avec les 100 connexions par défaut de PostgreSQL, 20 à 30 workers tiennent sans difficulté. Les deux nombres sont des variables d’environnement (WORKERS, WORKERS_CHAT) : monter en charge, c’est changer un chiffre, pas réécrire du code.
Il reste deux chantiers identifiés. L’intégration d’un nouvel employé et l’essai d’un site appellent encore l’IA pendant la requête HTTP (10 à 40 secondes, un fil FrankenPHP occupé) : c’est rare, sans effet mesurable ici, mais à passer en file si les embauches deviennent nombreuses en même temps. Et l’équité entre comptes dans la file du fond n’existe pas : premier arrivé, premier servi. Un compte qui lancerait des centaines de missions passerait avant les autres. Les surveillances limitent déjà à 3 travaux par passage, mais ce n’est pas une vraie équité.
Les leçons
- Mesurez l’attente, pas seulement la durée. Sans
startedAt, on aurait vu 107 secondes de réponse et accusé le modèle. Avec, on voit 301 secondes de file et quelques secondes de travail. - Un agent IA occupe un processus tout le temps qu’il réfléchit. Ce n’est pas une requête web de 50 ms. Le serveur HTTP tient sans effort ; ce sont les workers qu’il faut compter.
- Classez les travaux par « quelqu’un attend‑il ? », pas par type technique. La même mission va dans deux files différentes selon qu’une personne a cliqué ou non.
- La priorité ne suffit pas, il faut des places réservées. Un worker occupé par une mission de 30 secondes ne la lâche pas pour un message.
- Simulez l’IA avec ses vrais délais. Une IA instantanée aurait caché le problème, une vraie IA aurait coûté cher et mesuré le fournisseur. Un décorateur calé sur les délais mesurés donne le comportement de la pile pour presque rien.
- Relisez la configuration, pas le commentaire.
postgresql://etpostgresql+advisory://se ressemblent, mais l’un expire à 10 minutes et l’autre non. - Les garde-fous écrits pour un worker deviennent des bugs à douze. « En file depuis 20 minutes = bloqué » était vrai à petite échelle, et aurait effacé la rafale du matin sous charge.